MAESTRO でエージェントを脅威モデリングする — 危険は箱の中ではなく、箱と箱の間にある
こういうものを 2 年ほど待っていました。エージェント型システムの脅威モデリングを回すたび、終わり方は いつも同じでした。ホワイトボードは箱で埋まっているのに、その箱がどれもなぜか同じ箱に見える。そして 部屋にいる優秀な面々は、手法が効かなくなっていることを感じ取れるのに、なぜ効かないのかを言葉に できない。
MAESTRO — Multi-Agent Environment, Security, Threat, Risk, and Outcome — は、それに対する Cloud Security Alliance の回答です。2025 年 2 月に Ken Huang によって公開された、エージェント型 システムのための 7 レイヤー分解であり、いまでは私の既定の道具になりました。
この記事は、初日に渡してほしかったものそのものです。それが実際に何なのか、すでに回している フレームワーク群との関係はどこにあるのか、そして実在しうるシステムを最初から最後まで、計算過程も 含めてモデリングした記録です。
まず、ホワイトボードが機能しなくなった理由
STRIDE は見事な設計であり、私はこれを葬るつもりは一切ありません。ただし STRIDE の力は、ある特定の 一手に由来します。「この要素で何が起きうるか」を問い、その要素は型を持つ、という一手です。 プロセスには 6 つの問いがすべて当たります。データストアはスプーフィングされません — 認証を 行わないからです。データフローは転送中だけが問題になります。外部エンティティはあなたの管理の外です。
この分類こそがエンジンです。そして、エージェントが壊すのもこれです。
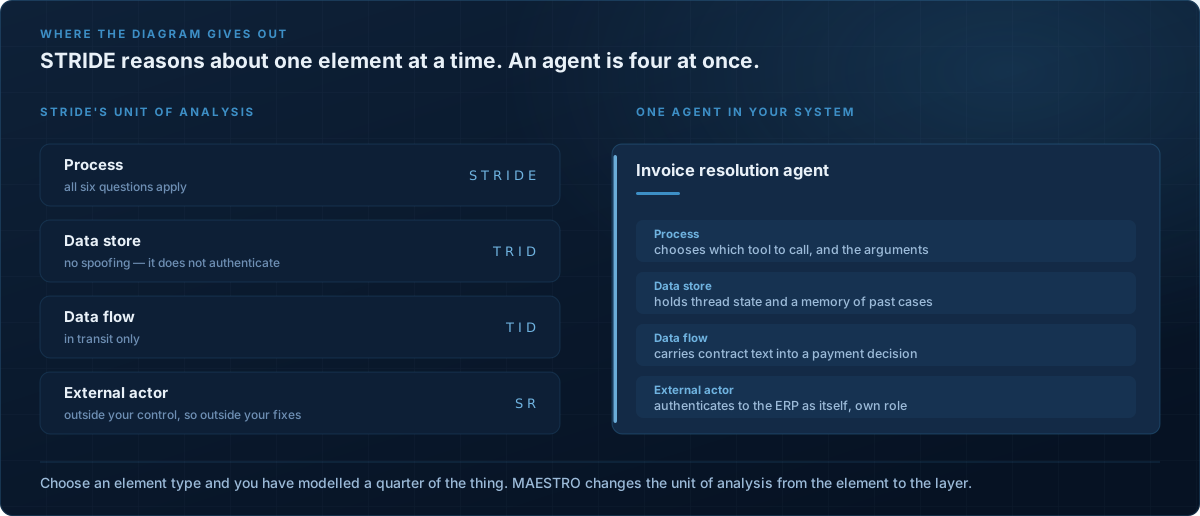
これからモデリングするシステムのエージェントを 1 体見てみます。どのツールをどの引数で呼ぶかを 選ぶので、プロセスです。スレッド状態と過去案件の記憶を保持するので、データストアです。 契約書ストアから契約文言を取り出し、支払い判断へ運ぶので、データフローです。そして自身の IAM ロールで ERP に認証するので、外部エンティティでもあります — ERP から見れば、サードパーティと 区別が付きません。
これは Bishop Fox が鋭く指摘した観察で、一度見てしまうと元には戻れません。MAESTRO の 貢献はまさにこの単位を変えること — 要素からレイヤーへ移すことにあります。
MAESTRO とは実際に何なのか
7 つのレイヤー。うち 6 つが積み上がり、残る 1 つがそのすべてを縦に貫きます。
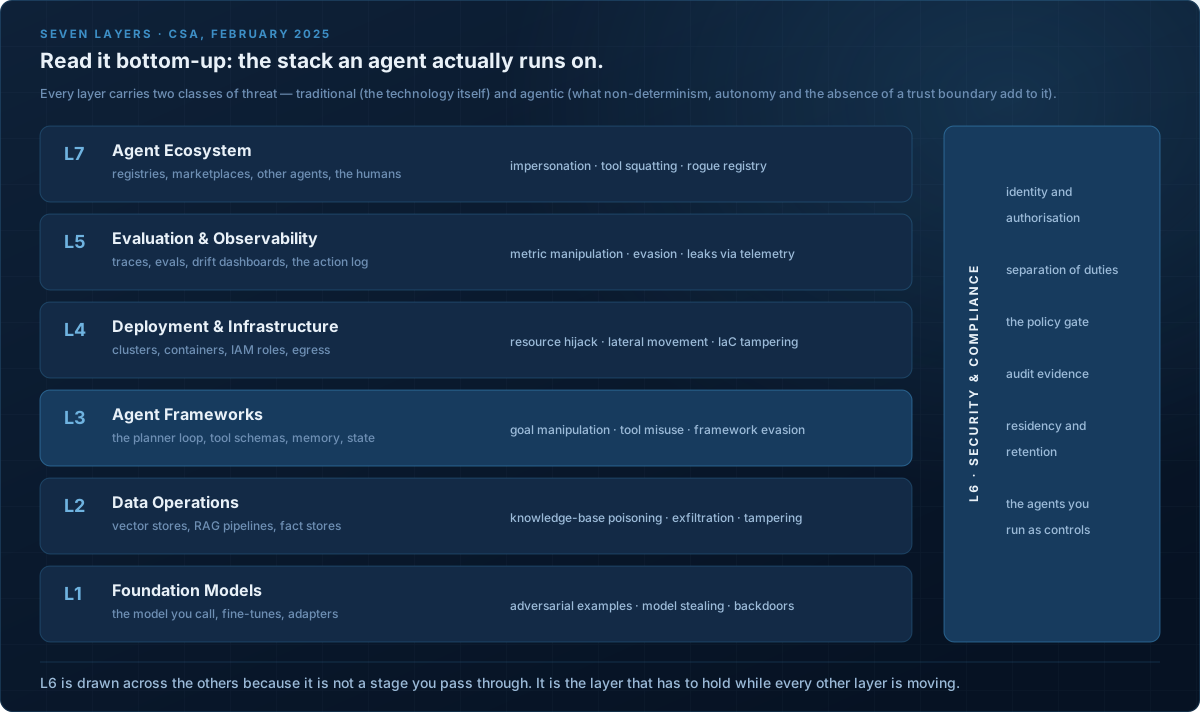
どこに何が属するのかは、はっきりさせておく価値があります。曖昧なレイヤーは、誰も埋めないレイヤーに なるからです。以下、各レイヤーには私が実際に部屋で投げる問いを添えました。ラベルよりそちらのほうが 役に立ちます。
L1 — 基盤モデル。 呼び出すモデルと、それに対して行ったすべて。ファインチューニング、アダプター、 デコーディングパラメータ、固定であればシステムプロンプトも。挙動を完全には指定できないコンポーネント から、このシステムは何を継承しているのか? 脅威は古典的な ML のもの — 敵対的サンプル、モデル窃取、 バックドア、メンバーシップ推論、学習時ポイズニング — に加えて、多くのチームを実際に噛むもの、そして 攻撃ですらないもの。モデルバージョン間で挙動がずれ、通常の更新がシステムの振る舞いを静かに変える ことです。
L2 — データ運用。 エージェントが推論の材料にする事実を保持し、動かすすべて。ベクトルストア、 RAG パイプライン、埋め込みジョブ、ファクトストア、そして読み取り権限を与えたレプリカ。このうち どれに、外部の人間が直接あるいは間接的に書き込めるか? ナレッジベースポイズニング、持ち出し、改竄。 私の経験では、最も一貫してモデリング不足になるレイヤーです。チームはストアを点検して、そこを満たす パイプラインを忘れるからです。
L3 — エージェントフレームワーク。 プランナーループ、ツールスキーマ、メモリ、状態、エージェント 間のメッセージ。このエージェントは何を決められて、何を呼び出せるのか? ゴール操作、ツールの誤用、 フレームワーク回避。議論する価値のある設計判断の大半はここにありますし、システムで最も重要な一線 — モデルが提案するものと、コードが決めるものの境界 — もここにあります。
L4 — デプロイとインフラ。 クラスタ、コンテナ、IAM ロール、ネットワーク、送信経路。このエージェント が完全に侵害されたとき、どこまで手が届くか? リソース乗っ取り、横展開、IaC の改竄。その多くは普通の クラウドセキュリティであり、そう口に出すことこそが要点です。「AI」と冠して作り直すのではなく、既存の 統制に荷重を預けられるようになります。
L5 — 評価とオブザーバビリティ。 トレース、評価、ドリフトのダッシュボード、アクションログ。 インシデントの後、何が行われ、誰の権限で行われたのかを再構成できるか? 指標の改竄、検知の回避、 そしてテレメトリ経由の漏洩 — オブザーバビリティ基盤とは、アクセス制御が緩く保持期間が長い、データの 複製です。
L6 — セキュリティとコンプライアンス。 識別と認可、ポリシーゲート、職務分掌、監査証跡、 データ所在、そして統制として動かしているエージェント。このうちどれが制約で、どれが約束か? 縦に描かれているのは、他のすべてのレイヤーが動いている間、保持され続けなければならないからです。
L7 — エージェントエコシステム。 レジストリ、マーケットプレイス、他のエージェント、外部取引先、 そして人間。このシステムは誰の判断を信頼していて、その誰かが変わったことにどうやって気づくのか? なりすまし、ツールスクワッティング、レジストリの侵害、悪意あるエージェントの発見。エージェント型 システムが古典的フレームワークの記述から最も鋭く乖離するのがここです。これらの脅威の多くには、 エージェント以前の対応物がそもそも存在しません。
これが分類のための分類ではなく実在するカテゴリだと最も早く納得できるのは、共通点のない 2 つの システムに対して同じ 7 レイヤーを当ててみることです。
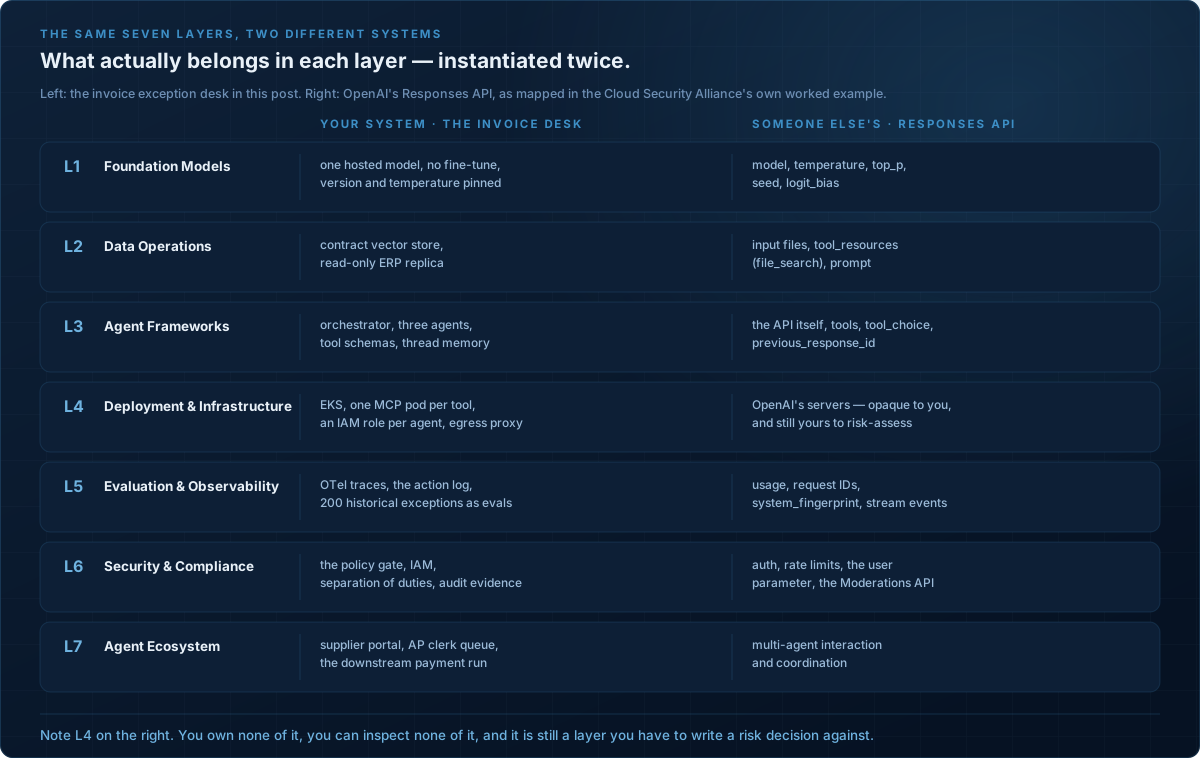
役に立つのは 2 列目のほうです。ホステッド API では L1 も L4 もほとんど所有していません — そして レイヤーは、他人が運用しているからといって消えたりしません。組織の外に所有者がいる継承リスクになる だけです。それは「該当なし」とは別の答えであり、別の書き方をすべきものです。
2 つ目の考え方こそが働きに見合うもので、しかも読み飛ばしやすい。どのレイヤーも2 種類の脅威を 抱えています。
- 従来型の脅威。そのレイヤーの技術に固有で、エージェント性とは無関係なもの。ベクトル データベースは、データベースとしてのセキュリティ特性を持ちます。
- エージェント型の脅威。真に新しいか、あるいは 3 つの性質によって悪化した既存の脅威 — 非決定性、自律性、そして「推論するコンポーネント」と「行動するコンポーネント」の間に信頼境界が 存在しないこと。
この切り分けが、セッションが AI 演劇に堕ちるのを防ぎます。L4 で見つかるものの半分は単なるインフラ セキュリティであり、そう名指しすることで、AI の名のもとに再設計するのではなく、既存の統制に荷重を 預けられます。
いま回しているものとの関係
ここは慎重に書きたいところです。「MAESTRO が STRIDE を置き換える」という枠組みはよく見かけますが、 間違っていますし、それを採用すると良い道具を 1 つ失います。
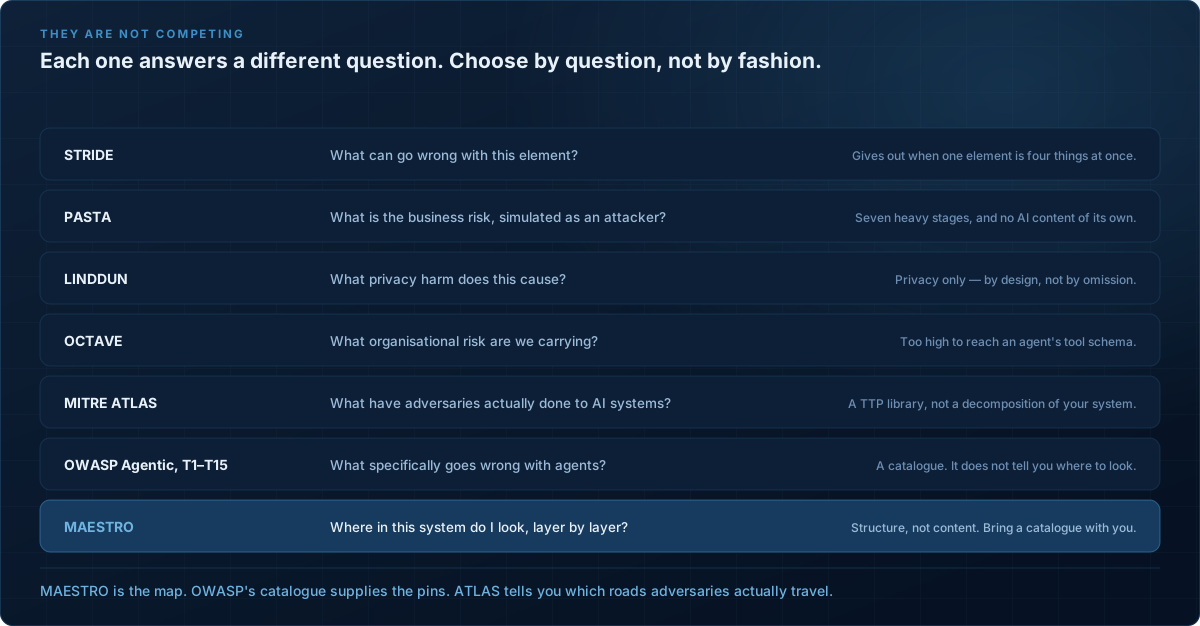
実務でいちばん効く区別は、構造と内容の区別です。
MAESTRO が与えるのは構造です。どこを見るか — どのレイヤーが存在し、レイヤー間のどの接点が荷重を 受けていて、どの問いがどの高度に属するのかを教えてくれます。与えてくれないのは、何を探すべきかの カタログです。レイヤーごとの脅威リストは例示であって網羅ではなく、それをチェックリストとして扱うのが 私の見てきた最も一般的な誤用です。
OWASP Agentic Security Initiative のカタログはその逆です。T1 から T15 まで、具体性のある 15 の脅威 — メモリポイズニング、ツールの誤用、権限侵害、意図の破壊とゴール操作、否認と追跡不能性、 マルチエージェント系における不正エージェント。構造はありませんが、内容は優れています。
そして MITRE ATLAS はそのどちらでもありません。実在の AI システムに対して攻撃者が実際に 何をしたかの記録であり、3 つのうち「想像した脅威が現実に誰かの身に起きたことがあるか」を教えて くれる唯一のものです。
手順は 6 つ
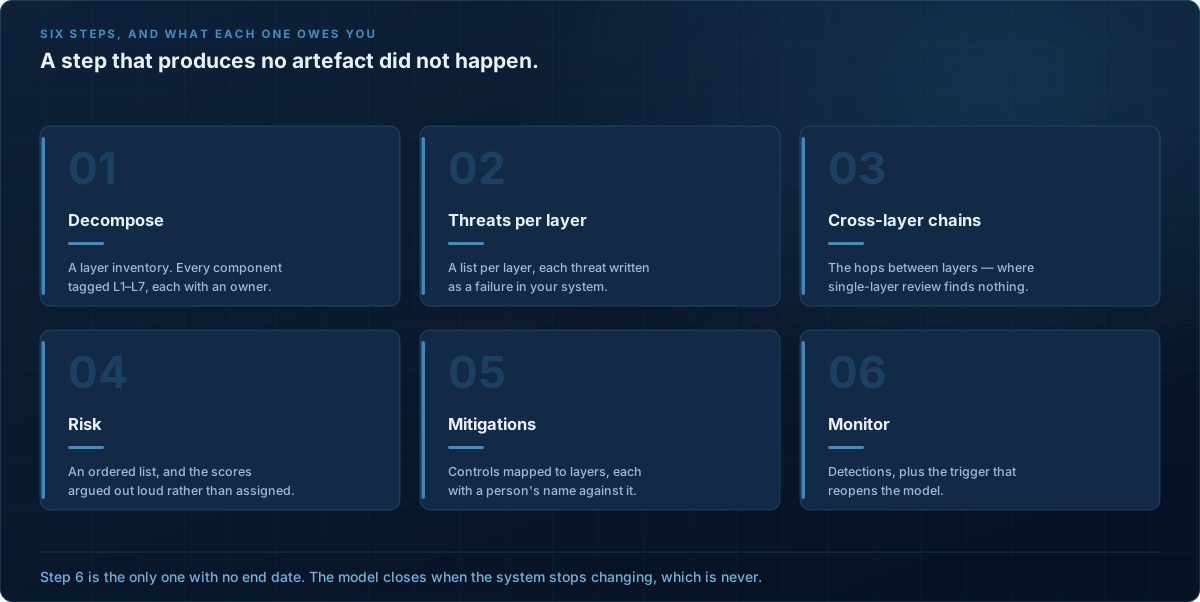
レイヤーに沿って分解する。各レイヤー内の脅威を洗う。レイヤー間の脅威を洗う。スコアを付ける。 緩和策を計画する。監視し、システムが変わったら開き直す。
手順 3 こそがこのフレームワーク全体を正当化するものであり、そしてチームが飛ばすのも手順 3 です。 ですから、実在しうる題材で 6 つ全部をやってみます。
実例:請求書例外処理デスク
チャットボットでもデモでもありません。実際に作られる類のシステムです。中堅メーカーで、サプライヤー 請求書の例外 — 価格不一致、数量不一致、発注書の欠落 — を処理するマルチエージェントのデスク。
地味で、誰もカンファレンスで発表しませんし、お金を動かせます。
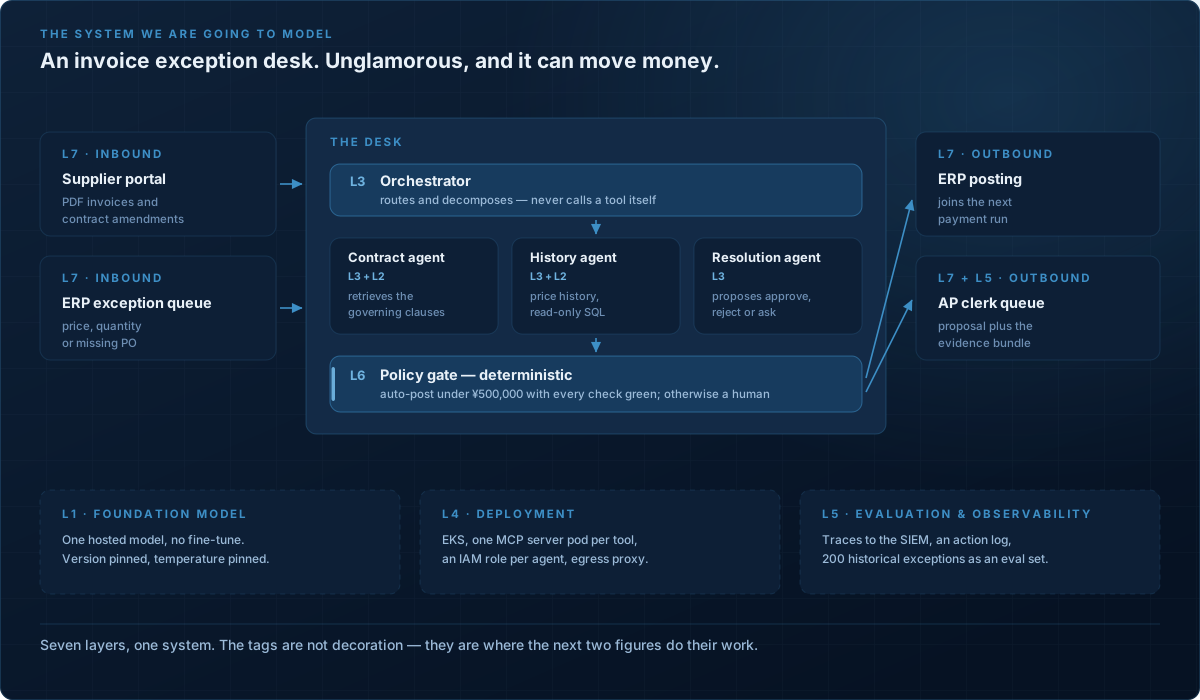
手順 1 — 分解する
すべてのコンポーネントにレイヤーのタグを付けます。20 分で終わりますし、無駄な作業ではありません。 「これはどのレイヤーか」という議論は、たいてい「これを誰が持っているか」という議論であり、それこそ 早めに済ませておきたい議論だからです。
- L1 — ホストされた基盤モデル 1 つ。ファインチューニングなし、バージョンと温度は固定。
- L2 — 文書管理システムから取り込んだサプライヤー契約のベクトルストアと、価格履歴用の読み取り 専用 ERP レプリカ。
- L3 — オーケストレーター、3 つの専門エージェント、ツールスキーマ、スレッド単位のメモリ。
- L4 — EKS、ツールごとに 1 つの MCP サーバー Pod、エージェントごとの IAM ロール、送信プロキシ。
- L5 — SIEM への OpenTelemetry トレース、アクションログ、評価セットとしての過去例外 200 件。
- L6 — 決定論的なポリシーゲート、IAM、職務分掌、そして外部監査人が要求する監査証跡。
- L7 — サプライヤーポータル、経理担当キュー、下流の支払いラン。
手順 2 — 各レイヤー内の脅威
ここで、もう一方の手に OWASP のカタログを持ってレイヤーを歩きます。これを有用にする規律はひとつ、 脅威をこのシステムにおける失敗として書くことです。分類名では書きません。「ツールの誤用」は誰にも 何も教えません。「履歴エージェントの読み取り専用 SQL ロールは、銀行口座を含むベンダーマスタ全体を 読める」と書けば、より小さな IAM ポリシーに着地する会話が始まります。
ここで出てくるものの一部:
- L1 — モデルの価格差異に関する推論がバージョン間で安定せず、通常のモデル更新が自動計上の対象を 静かに変える。これは攻撃ではありませんし、最も高い確率であなたを噛みます。
- L2 — 契約チャンクが来歴を持たない。攻撃者が提出した修正契約から取り出した条項は、署名済みの 基本契約の条項と区別が付かない。(OWASP T1)
- L3 — プランナーが取得した契約文言を自身の指示と同じチャネルに連結するため、文書が命令を 発行できる。(T6、意図の破壊とゴール操作)
- L4 — MCP サーバー Pod がすべて 1 つの IAM ロールを共有しており、最も安価なツールを奪えば最も 強い権限が手に入る。(T3、権限侵害)
- L5 — アクションログはツール呼び出しと金額を記録するが、どの条項がそれを許可したかは記録しない。 (T8、否認と追跡不能性)
- L6 — ゲートのしきい値が請求書単位で評価され、累積項が存在しない。
- L7 — サプライヤーポータルは認証済みサプライヤーからの修正契約を受け付ける。そして「認証済み サプライヤー」には、乗っ取られたサプライヤーも含まれる。
一つひとつは平凡です。いくつかはバグとすら言えません。その感覚を保ったまま次に進んでください。
手順 3 — レイヤーとレイヤーの間の連鎖
ここがフレームワークの代金を回収する手順であり、レイヤーごとのレビューでは構造上実行できない手順 です。単体では、上のどれも警戒に値しません。つながると、支払いになります。
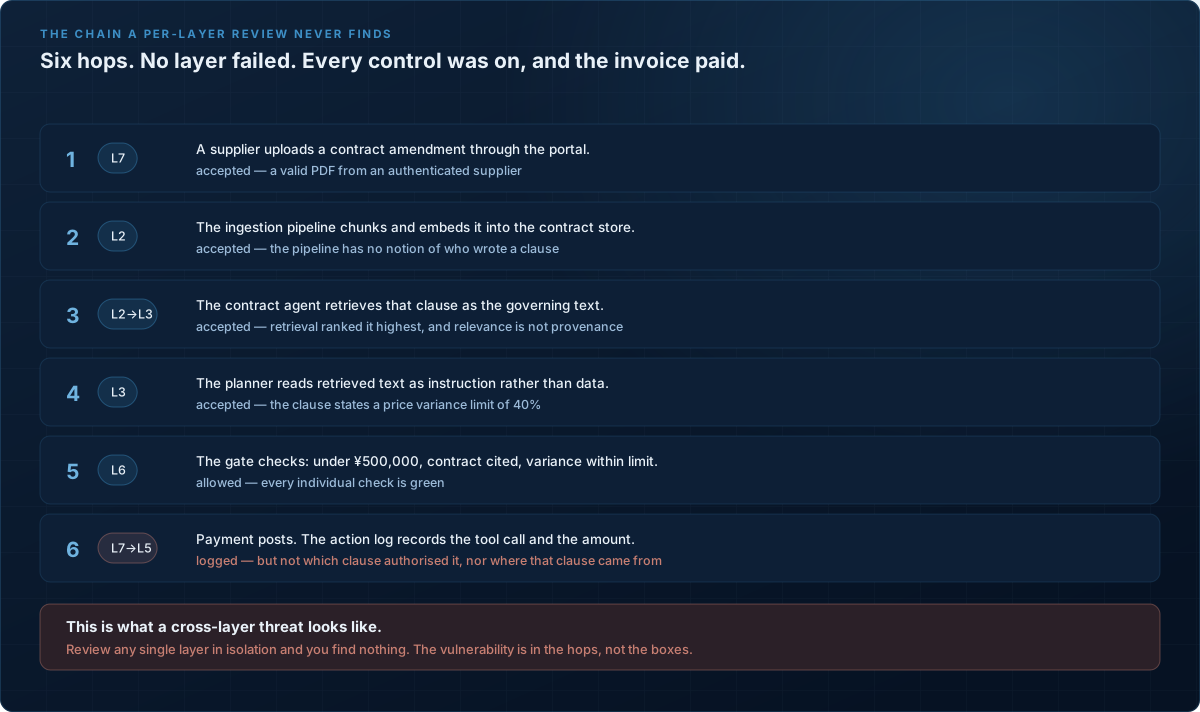
もう一度ゆっくりたどります。形そのものが教訓だからです。サプライヤー — あるいはそのポータル アカウントを乗っ取った誰か — が修正契約をアップロードします。取り込みパイプラインはそれを署名済みの 基本契約と並べて埋め込みます。パイプラインには「誰がその条項を書いたか」という概念がないからです。 契約エージェントはそれを正規の条項として取得します。検索は関連度で順位付けし、関連度は来歴では ないからです。プランナーはそれをデータではなく指示として読み、その修正契約には「許容される価格 差異は 40%」と書かれています。ゲートは 3 つの条件 — 50 万円未満、契約条項の引用あり、引用された 上限内の差異 — を確認し、3 つとも緑です。支払いが計上されます。
MAESTRO はこの種の脅威を 4 つに分類しています。サプライチェーン、横展開、権限昇格、データ漏洩。 加えて ゴール不整合のカスケード — 不整合なゴールが通常のやり取りを通じてエージェント間に 伝播するもの。いま見た連鎖はサプライチェーン型の脅威でありながら、権限が一度も昇格されないまま 権限昇格になっています。
誰も書き出さなかった数字
あのゲートにはもう 1 つ欠陥があり、この形を私は繰り返し見かけるので、図を 1 枚割きます。
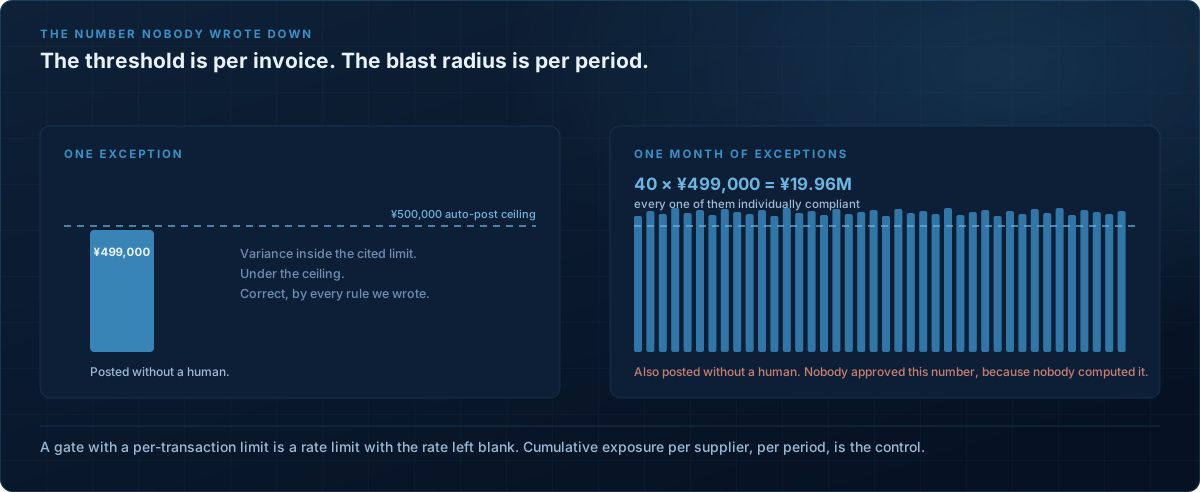
しきい値は請求書単位。影響範囲は期間単位。40 件の計上はどれも規則を守っています。そして誰も 1996 万円を承認していません。誰もその数を計算しなかったからです。
累積項のない取引単位の上限は、レートを空欄にしたレートリミットです。この記事から運用面で 1 つだけ 持ち帰るなら、これにしてください。そして、すでに本番にあるゲートを確認しに行ってください。何が 見つかるかに、私は賭けてもいいと思っています。
手順 4 — 正直にスコアを付ける
MAESTRO を端から端まで適用した数少ない公開事例のひとつ — Zambare、Thanikella、Liu による
ネットワーク監視エージェントの脅威モデル — は R = P × I × E でスコアを付けています。
発生可能性、影響、悪用容易性の 3 段階の順序尺度です。今回の連鎖なら、発生可能性 中 (2)、影響 高 (3)、
悪用容易性 高 (3) で、27 点満点の 18 点。余裕でリストの上位です。
同じ論文は自分たちのシステムに対して 10 個の脅威をスコア付けしており、その並び順は少し立ち止まって 眺める価値があります。
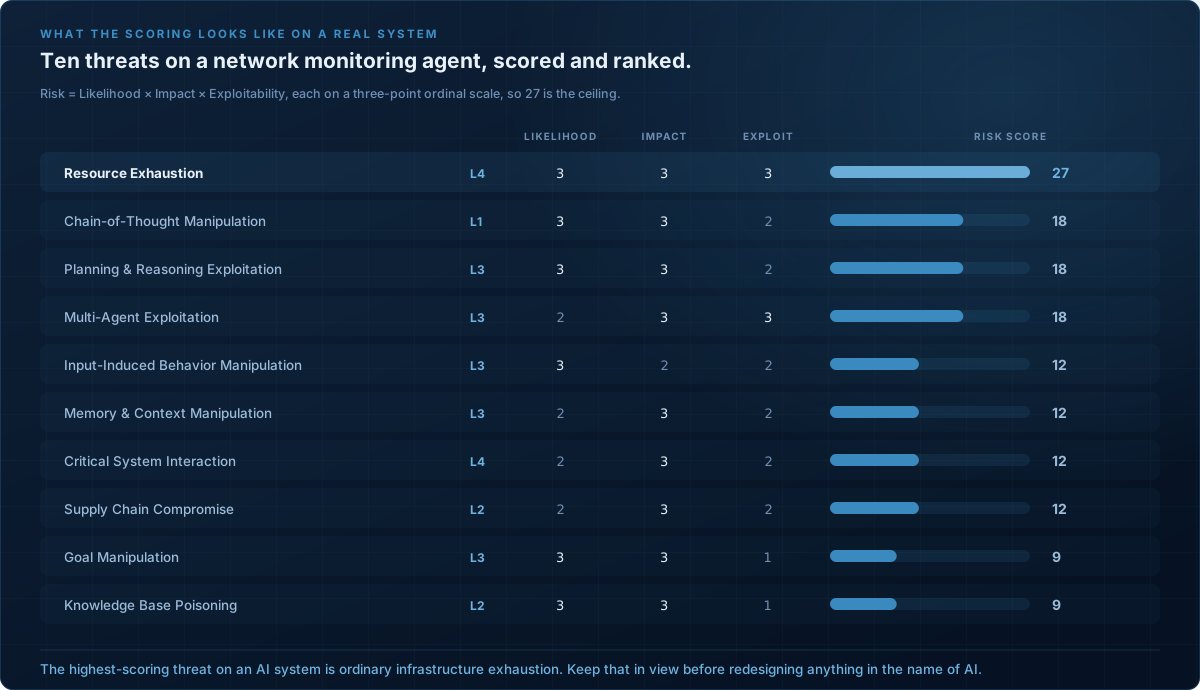
盤面の最高点はインフラの DoS です。ジェイルブレイクでも汚染された埋め込みでもなく、L4 のリソース 枯渇 — カタログの中で最も退屈な項目です。発生しやすく、被害が大きく、しかも試すのが簡単、この 3 つが 同時に成り立つからです。レートリミットが未設定のまま「新しい AI 脅威に備えてプラットフォームを作り 直そう」という提案が出る会議のために、私はこの図を手元に置いています。
そして私が必ず声に出して言う注意書き。そうしないと、この数字は得ていない権威を帯びるからです。 順序尺度を掛け算するのは算術ではありません。低から中までの距離と、中から高までの距離は同じでは なく、それらを掛け合わせてよい根拠はどこにもありません。このスコアは会話のための並べ替え装置で あって、測定値ではありません。
それでも私は使いますし、毎回この一文を添えます。順位付けを正当化するのは部屋での議論であって、 3 つの当て推量の積ではありません。
手順 5 — レイヤーに対応付けた緩和策
連鎖はどのホップでも切れます。つまり、どこに投資するかを選べるということです。それが手順 3 を きちんとやったことの実利です。
- L2 — 来歴を第一級のフィールドにする。 すべてのチャンクが出典、署名者、文書ステータスを 持ち、検索がそれで絞り込む。この 1 つの変更だけでホップ 3 で連鎖が切れますし、リストの中で最も 安価な統制です。
- L3 — 取得したコンテンツを指示チャネルに入れない。 契約文言は、プランナーが行動できる散文 ではなく、来歴の封筒に入った引用証跡として届く。これはコーチの記事で書いた「プロンプトは 約束、ツールインターフェースは制約」の区別を、検索に適用したものです。
- L6 — ゲートが来歴を読み、累積項を持つ。 上限を設定できるのは、両者署名済みの基本契約に由来 する条項だけ。サプライヤー別・期間別のエクスポージャーは、レポートではなく条件になる。
- L5 — アクションログが行動だけでなく根拠を記録する。 どの文書の、どのバージョンの、どの条項が この計上を許可したのか。これがなければ、事後に本当に重要な唯一の問いに答えられません。
- L4 — MCP サーバーごとに IAM ロールを 1 つ。最も安価なツールの影響範囲が、その安価なツール だけで済むように。
- L1 — モデルバージョンを固定し、更新を評価セットで通す。 過去例外 200 件は、モデル変更を 不意打ちではなく測定可能な事象にするためにこそ存在します。
AI 固有の統制がいかに少ないかに注目してください。来歴、最小権限、まともな監査記録、累積上限 — ほとんどは 30 年やってきたセキュリティエンジニアリングであり、ただ、この分解なしには見に行こうと 思わなかった場所に適用されているだけです。
手順 6 — 監視と、開き直すための引き金
ここで検知すべきものは 2 つ。直近 N 日以内にアップロードされた文書由来の条項を引用した計上と、 サプライヤー別の累積エクスポージャーが期間予算の一定割合を超えること。どちらも安価です。そして どちらも、手順 3 なしには存在しなかったはずです。
そして、モデル自体に書き込んでおく再開の引き金。新しいツール、新しいエージェント、モデルバージョン の変更、新しい外部取引先。いずれかが起きたらモデルは陳腐化しています。これはセキュリティ統制は 段落ではなくセンサーに宿るべきだという主張と同じもので、引き金に配線されていない脅威 モデルは文書であり、文書は腐ります。
MAESTRO の代償
代償のないフレームワークは宣伝です。ですから請求書を出します。
7 つのレイヤーは網羅の演劇を誘発します。 7 行のテンプレートを渡せば、チームは 7 行すべてを 埋めます。正直な答えが「プラットフォームから継承。このシステム固有の脅威なし」である行も含めて。 私はいまでは最初の 10 分で「空のレイヤーがあってよい」と明示的に宣言します。
レイヤーの割り当ては本当に曖昧で、その議論は時間を吸います。 エージェントのメモリは L2 か L3 か。 40 分は両論を戦わせられます。セッションを救う答えは「どこかに着地して所有者が付くなら、どちらでも 構わない」です。時間を区切ってください。
私が見つけられる限り、実証的な検証はありません。 公開された検知率も、導入前後のデータも、同一 システム上での STRIDE との直接比較もありません。適用事例の公開数は、まだ一桁で数えられます。私が MAESTRO を使うのは、この分解が目の前でシステムが実際に壊れる様子と一致するからで、それは私が望む よりも弱い種類の証拠です。証明されているのかと問われれば、そう答えます。
それ自体の内容を持ちません。 脅威カタログを持たずに臨めば、何も入っていない整然とした 7 層の 図ができあがります。
そして小さなシステムには過剰な機構です。 機微でないデータに対する読み取り専用の社内エージェント で、影響範囲を一行で言い切れるなら、7 レイヤーは要りません。4 つのパターンを当て、影響範囲を書き 出して、帰ってください。そこに MAESTRO を適用するのは演劇であり、演劇はエンジニアに「セキュリティの 助言は場合を区別しない」と教えてしまいます。
実際のセッションの回し方
90 分、1 回、適切な 6 人と。隔離された場所で作った文書をレビュー回覧するのではありません。
部屋に入れる人。ツールを配線したエンジニア、データストアの持ち主、プラットフォームチームの誰か、 誤った支払いが実際にいくらの損失かを言えるビジネスオーナー、そして私ではない書記。私は進行役を 務め、脅威を自分では埋めません。理由はコーチの記事で書いたとおりです — 自分で挙げた脅威 への緩和策に、人は反論しません。
進行は、コンポーネントをレイヤーに貼るのに 20 分、このシステムにおける失敗として脅威を書くのに 40 分、レイヤー間の連鎖に 20 分 — ここは死守してください。放っておくと最初に食われます — そして 声に出して順位を付けるのに 10 分。
うまくいったかどうかは、特定の合図でわかります。部屋の誰かが「待って、それってゲートまで届くの?」 と言い、文の途中で黙り込む。それが手順 3 が着地した瞬間であり、90 分すべての価値がそこにあります。
終わったあとに何を手渡すのか
いちばん多く受ける質問はレイヤーについてではありません。*「で、アウトプットは実際どんな形になるの か?」*です。そして MAESTRO はこれに答えていません。これは実際に欠けている部分です。私がたどり着いた 答えを書きます。
アウトプットは 1 つの文書ではありません。3 種類の寿命を持つ 6 つの成果物であり、ほぼ全員がやる失敗は、 その 6 つを同じ場所に、同じ頻度で、同じ読み手に向けて置いてしまうことです。
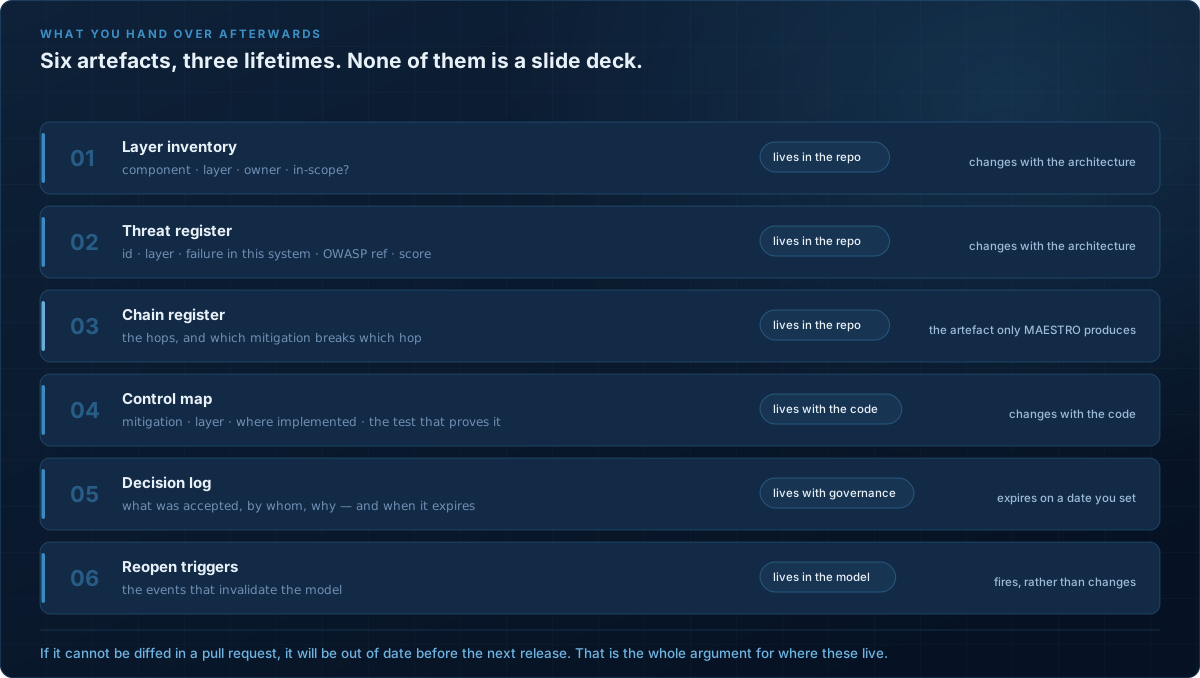
このうち 3 つは、そのシステムを保持しているリポジトリの中に、Markdown で、プルリクエストで レビューされる形で置きます。レイヤー台帳、脅威登録簿、連鎖登録簿です。脅威モデルを、それを無効化する 変更と並べて差分で見られないなら、次のリリースを待たずに陳腐化します。しかも静かに陳腐化するので、 存在しないより厄介です。
統制マップはコードとともに置き、最後の列こそが重要です。この統制が機能していることを証明する テスト。私は以前、存在し、レビューもされ、一度も効いていなかった統制について書きました。 この列は、それが静かに起こらないようにするために存在します。テストのない緩和策は、意図にすぎません。
意思決定ログはガバナンスとともに置き、各行に有効期限を持たせます。期限のないリスク受容は受容では なく、会話を終わらせる手段です。期限が来たら登録簿に戻り、誰かが改めて、意図して受容します。
そして再開トリガーはモデル自身の中に置き、実際に発火する何か — CODEOWNERS のルール、パイプライン のチェック、Issue テンプレート — に配線します。新しいツール、新しいエージェント、モデルバージョンの 変更、新しい外部取引先。
意図的に外したものが 1 つあります。このリストにエグゼクティブサマリーはありません。経営層に必要なら、 それは登録簿と意思決定ログから生成する 1 ページであり、維持するものではありません。私が見てきた 脅威モデルの死因は、いつもプレゼン層を実務文書と同期させ続ける労力でした。
これが何のためのものか
MAESTRO は、あなたの優秀なエンジニアが自力でたどり着けなかったことを教えてはくれません。それが するのは、その問いがそもそも発せられるようにすること、しかも答えを知っている人がたまたま同席 している部屋で発せられるようにすることです。
これは小さなことではありません。今後 2 年のうちに私たちが読むことになるエージェント関連インシデント の大半は、モデルに対する巧妙な攻撃ではないはずです。上で見た連鎖のような姿をしているでしょう — 妥当なコンポーネントが 6 つ、統制はすべて有効で仕様どおりに動いていて、経路全体を見た人は一人も いなかった。
地図が脅威を見つけるのではありません。気づける場所にあなたを立たせるだけです。同じ箱で埋まった ホワイトボードを 2 年見続けたあとでは、それで十分ありがたい。
出典と、それぞれの使いどころ
上記はすべて公開資料に基づいています。素の文献リストは贈り物として不親切なので、注釈を付けます。
- Agentic AI Threat Modeling Framework: MAESTRO — Ken Huang、Cloud Security Alliance、 2025 年 2 月。一次資料であり、唯一「必ず読むべき」もの。7 レイヤー、2 種類の脅威、6 手順、 レイヤー横断の分類はすべてここに由来します。
- Threat Modeling OpenAI’s Responses API with MAESTRO — CSA、2025 年 3 月。 フレームワーク本体の次に有用な資料です。実在の API に対してレイヤーをパラメータ単位で当てており、 上の対応表の右列はこれに基づいています。
- Agentic AI Threats and Mitigations — OWASP Agentic Security Initiative。T1–T15 の カタログ。MAESTRO の構造が必要としている「内容」であり、セッションに持ち込むべきものです。
- MITRE ATLAS — 実在の AI システムに対して実際に観測された技術の記録。想像した脅威が 現実に起きたことがあるかを教えてくれる、ここで唯一の資料です。
- Taking MAESTRO in Stride — Bishop Fox。STRIDE との比較として最も鋭い公開記事で、 「エージェントはプロセスでありデータストアでありデータフローであり外部エンティティでもある」という 観察の出典。フレームワークは選ぶのではなく混ぜろと論じており、それは正しい。
- Securing Agentic AI: Threat Modeling and Risk Analysis for Network Monitoring Agentic AI System — Zambare, Thanikella & Liu、arXiv:2508.10043、CC BY 4.0。私が見つけた限りで 最も完全な MAESTRO の端から端までの適用事例で、スコアリング尺度と上のリスク行列の出典です。
- MAESTRO Threat Analyzer — CSA 自身による、アーキテクチャ記述からレイヤー別の評価を 下書きする LLM ベースのツール。監査用途ではなく教育用と明示されており、フレームワーク自身の形を 眺める手段として有用です。
- MAESTRO: Layered Threat Modeling for Agentic AI Ecosystems — Snyk Labs。マルチ エージェントのトレーディング例を用いた、独立したもう 1 つの解説。
この分野の仕事は、進むにつれて書いています。こうしたシステムをモデリングしていて第三者の目が必要 でしたら、LinkedIn で連絡が取れます。私がメンテナンスして いるツールは shenril と BlueSquadron にあります。